2026
TKCAM: Text and Keyframe to Camera Trajectory Generation
Haozhe Yang, Zhiyang Dou, Zekai Gu, Cheng Lin, Wenping Wang, Yuan Liu, Taku Komura
Advances in Neural Information Processing Systems (NeurIPS), 2026 Poster
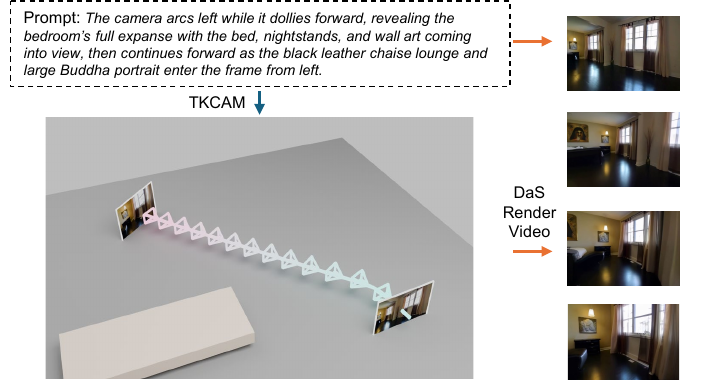
We introduce TKCAM, a text- and keyframe-conditioned camera trajectory generation framework based on generative masked modeling. Camera dynamics are formulated as continuous 12-dimensional kinematic sequences and discretized into hierarchical motion tokens via a Residual Vector Quantizer (RVQ), enabling a two-stage masked transformer to reconstruct temporally coherent trajectories from free-form text prompts and sparse RGB keyframes. TKCAM significantly surpasses recent state-of-the-art baselines on FID, text-motion matching, and retrieval metrics (R@K).
TKCAM: Text and Keyframe to Camera Trajectory Generation
Haozhe Yang, Zhiyang Dou, Zekai Gu, Cheng Lin, Wenping Wang, Yuan Liu, Taku Komura
Advances in Neural Information Processing Systems (NeurIPS), 2026 Poster
We introduce TKCAM, a text- and keyframe-conditioned camera trajectory generation framework based on generative masked modeling. Camera dynamics are formulated as continuous 12-dimensional kinematic sequences and discretized into hierarchical motion tokens via a Residual Vector Quantizer (RVQ), enabling a two-stage masked transformer to reconstruct temporally coherent trajectories from free-form text prompts and sparse RGB keyframes. TKCAM significantly surpasses recent state-of-the-art baselines on FID, text-motion matching, and retrieval metrics (R@K).